
2026.08.31
皆さんこんにちは!SaaS Harbor 運営です。
今回は、2026年7月28日(火)に開催された第3回 SaaS Harbor 「LLM Ops の実践 ― SaaS に組み込んだAI 機能の品質・コスト・改善サイクル ―」 の模様をレポートします。
当日は、Sansan 株式会社、freee 株式会社、株式会社ログラスの3社にご登壇いただき、AI 機能を本番運用するための設計や評価、改善について、それぞれの取り組みをご紹介いただきました。
本記事では、各セッションの内容とイベント当日の様子をお届けします。
1. SaaS Harbor について
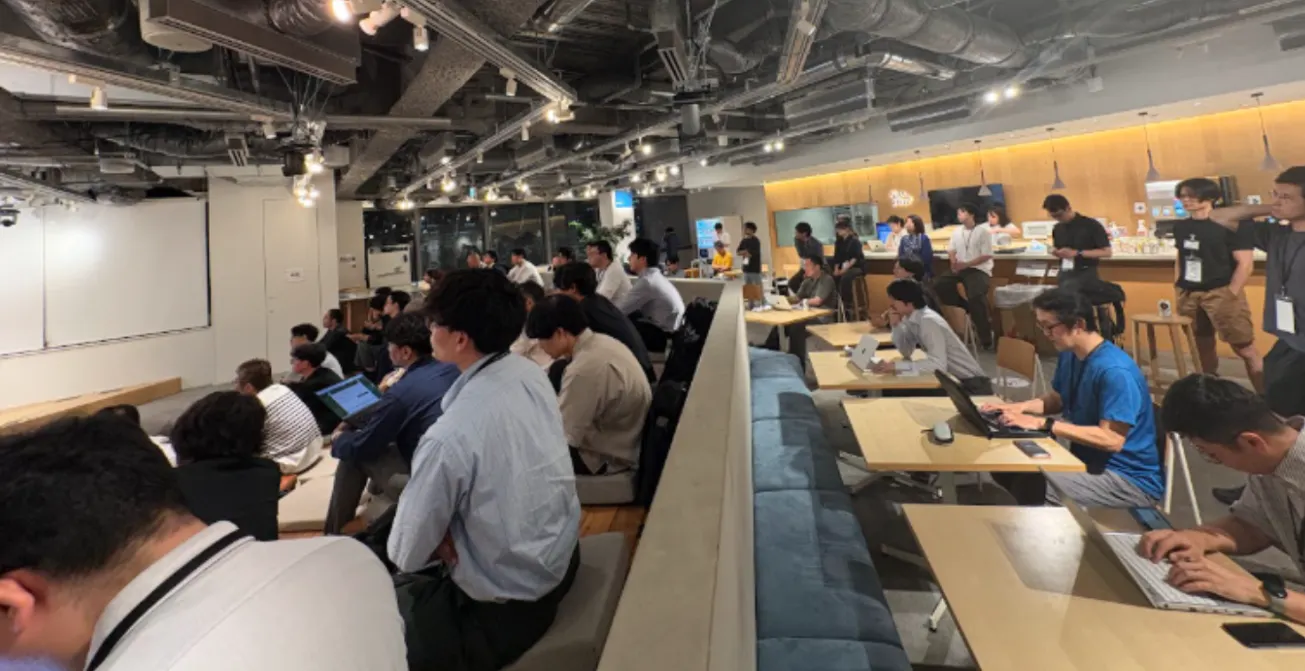
「SaaS Harbor(サースハーバー)」は、B2B SaaS に関わる人たちが、会社や職種の垣根を越えて現場の知見を共有し合うコミュニティです。
B2B SaaS の開発や運営では、検索しても答えが見つからない意思決定が数多くあります。SaaS Harbor では、成功事例だけでなく、「なぜその判断をしたのか」「どのような課題を乗り越えたのか」といった実践的な知見まで共有し、それぞれの現場で活かせる学びの場を目指しています。
2. 今回のイベント概要
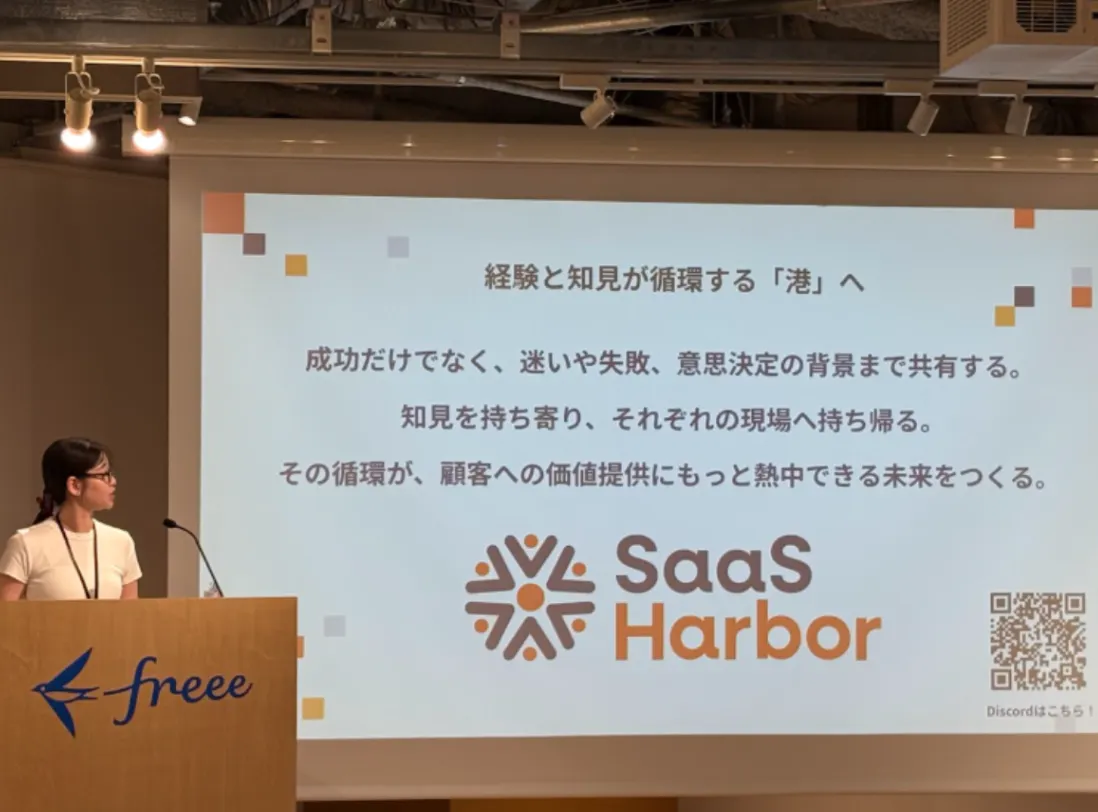
今回のテーマは「LLM Ops の実践 ― SaaS に組み込んだAI 機能の品質・コスト・改善サイクル ―」です。
生成AI を活用した機能をSaaS に組み込む企業が増える一方、本番運用では、品質評価やコスト管理、セキュリティ、可観測性、継続的な改善など、さまざまな課題に向き合う必要があります。
そこで今回は、実際にAI 機能を本番環境で提供している3社をお迎えし、AI 機能を継続的に運用・改善していくための設計や評価、改善サイクルなど、それぞれの現場で培われたLLM Ops の実践をご紹介いただきました。
また、当日はDiscord を通じてリアルタイムで質問を募集。セッション後には寄せられた質問をもとにQ&A を行い、登壇者と参加者が双方向に知見を深める機会となりました。
・開催日時:2026年7月28日(火)19:00〜21:30
・開催形式:オフライン
・テーマ:LLM Ops の実践 —SaaS に組み込んだAI 機能の品質・コスト・改善サイクル—
・登壇者:
・Sansan 株式会社 小松 展久 さん
・freee 株式会社 Kengo Nakamura さん
・株式会社ログラス 山崎 倫太郎 さん
今回のイベントの登壇資料とアーカイブ動画は、SaaS Harbor のDiscord で公開しています。各セッションをより詳しくご覧になりたい方は、ぜひご参加ください。
▶ SaaS Harbor Discord で登壇資料・アーカイブ動画を見る
3. セッション内容のご紹介
セッション1:セルフホストLangfuse を安全に本番運用するために必要だった設計と、そこから生まれた成果
登壇者:Sansan 株式会社 小松 展久 さん
最初のセッションでは、Sansan 株式会社の小松 展久さんより、「セルフホストLangfuse を安全に本番運用するために必要だった設計と、そこから生まれた成果」をテーマにご講演いただきました。
〈プロフィール〉
金融系SIer、通信会社、SaaS ベンチャーを経て2021年にSansan に入社。Contract One の開発・運用に携わり、その後は研究開発部で関連システムの開発・運用を担当。
〈セッション内容〉
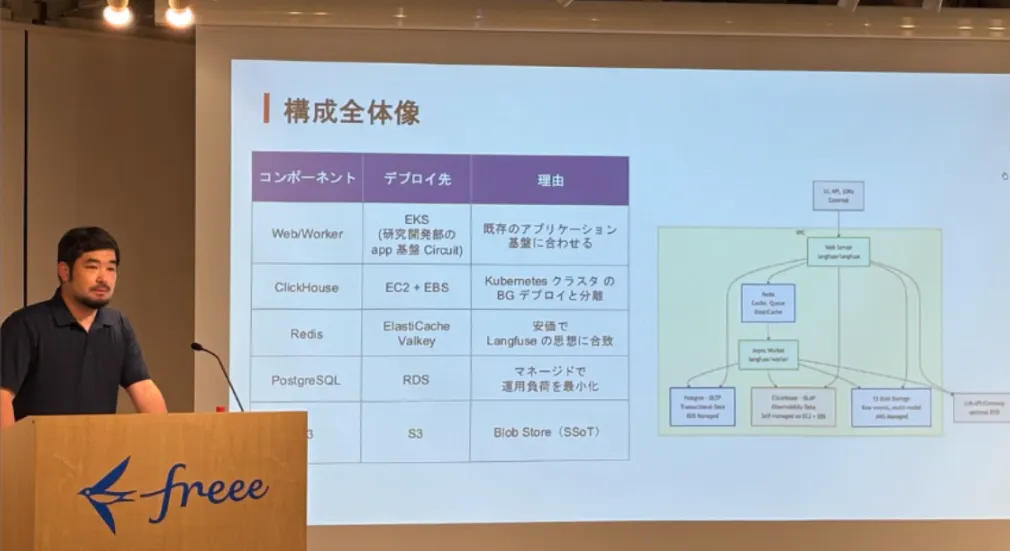
LLM アプリケーションの開発・運用では、プロンプトやモデルの改善だけでなく、ログの収集やトレースの可視化、品質評価といった運用基盤の整備が欠かせません。一方で、企業が扱うデータには機密情報が含まれることも多く、SaaS 版のツールをそのまま利用することが難しいケースもあります。
本セッションでは、Sansan 社がLangfuse をセルフホストで運用することを選択した背景から、本番環境で安心して利用するための設計について紹介いただきました。
具体的には、SSO やJust-In-Time プロビジョニングによる認証・認可、API Proxy を活用したアクセス制御、IP 制限やデータ保持・削除ポリシーなど、セキュリティと運用性を両立するための工夫が解説されました。
また、こうした基盤を整備したことで、開発者がトレースの確認や品質分析をスムーズに行えるようになり、AI 機能の改善サイクルをより効率的に回せるようになった事例も紹介されました。
LLM アプリケーションを本番運用するうえでは、AI モデルそのものだけではなく、安全に運用し続けるための基盤設計も重要であることを実感できるセッションでした。
〈当日Discord で寄せられた質問〉
Q. Langfuse を選定した決め手は何だったのでしょうか。
A. セルフホスト可能なツールはいくつかありましたが、セルフホスト環境でも十分な機能を利用できることが、Langfuse を選定した最大の理由です。加えて、ライセンスの扱いやすさやカスタマイズ性の高さも決め手になりました。
Q. 認証・認可の共通基盤がない場合でも、同じ構成を実現できるのでしょうか。
A. 今回の構成は、社内に共通認証基盤があったからこそ実現できたものです。ゼロから認証・認可基盤を構築する難易度は高く、もし共通基盤がなければ、セルフホスト自体を見送っていた可能性もあります。
セッション2:freee におけるEvals の実践例の紹介
登壇者:freee 株式会社 Kengo Nakamura さん
続いてのセッションでは、freee 株式会社のKengo Nakamura さんより、「freee におけるEvals の実践例の紹介」をテーマにご講演いただきました。
〈プロフィール〉
freee では一度DBRE のリーダーをした後転職、出戻りして基盤開発チームのテックリードを担当。現在はAI ラボに所属。
〈セッション内容〉
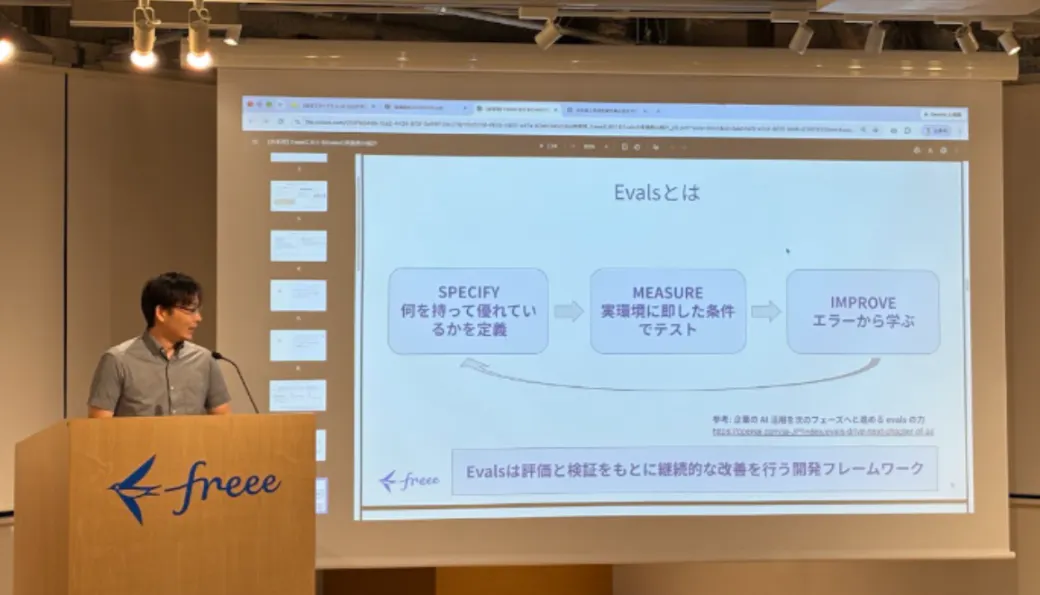
生成AI を活用したプロダクトでは、リリース後も品質を継続的に評価し、改善を繰り返していくことが重要です。本セッションでは、AI 機能の品質向上を支える「Evals(評価)」の考え方と、freee で実践している改善サイクルについてご紹介いただきました。
講演では、「Specify(仕様を定義する)」「Measure(評価する)」「Improve(改善する)」というサイクルを軸に、OCR 機能の改善事例を交えながら、評価基盤の構築方法や改善プロセスについて解説されました。また、AI ならではの課題だけでなく、入力値の検証やエラーハンドリング、インフラ構成の見直しといった、ソフトウェアエンジニアリングの基本的な改善が品質向上につながった事例も紹介されました。
さらに、評価は一度実施して終わるものではなく、ユーザーからのフィードバックや運用データをもとに継続的に見直していくことが重要であると説明されました。
AI プロダクトの品質は、モデルの性能だけで決まるものではありません。評価の仕組みを整え、改善サイクルを回し続けることが、ユーザーに価値を届け続けるための鍵であることを学べるセッションでした。
〈当日Discord で寄せられた質問〉
Q. Evals で重要な「計測」や「評価」は、どのように設計すればよいのでしょうか。
A. 既存の延長線上だけで考えるのではなく、「ユーザーに本当に提供したい体験」を起点に目標や評価指標を設計することが重要です。理想のユーザー体験から逆算して評価を設計することが、改善サイクルの土台になると考えています。
Q. オフライン評価とオンライン評価は、どちらも必要なのでしょうか。
A. オフライン評価だけでは、本番環境での実際の利用状況までは分かりません。そのため、実際のユーザー利用やフィードバックをもとにしたオンライン評価と組み合わせながら、継続的に改善していくことが重要です。
セッション3:決定論と非決定論を組み合わせたAI Agent の構築と改善
登壇者:株式会社ログラス 山崎 倫太郎 さん
最後のセッションでは、株式会社ログラスの山崎 倫太郎さんより、「決定論と非決定論を組み合わせたAI Agent の構築と改善」をテーマにご講演いただきました。
〈プロフィール〉
新卒でtoB 向けのコンサルティング・アナリティクス業務に従事した後、PdM 兼エンジニアへとキャリアチェンジ。主にサーバーサイドやクラウドインフラの開発を経験。IT ベンチャー数社にてWeb アプリケーションを中心に開発のリードを担当後、DeNA グループ会社にてエンジニア組織の副部長として開発組織マネジメントに従事。2025年からログラスにてFDE としてAI Agent 新規事業を担当。
〈セッション内容〉
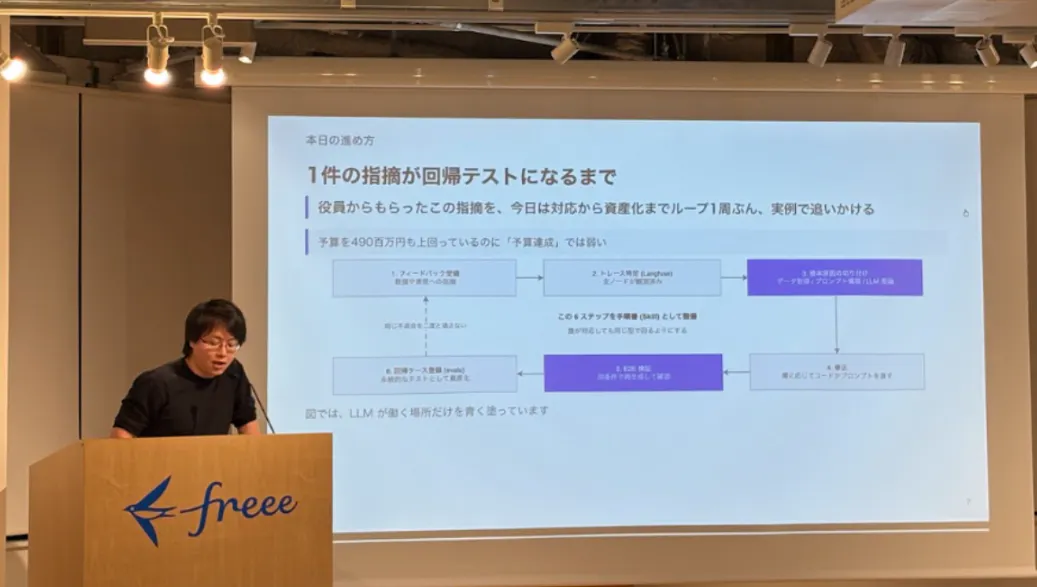
AI Agent の開発では、LLM にすべての処理を任せるのではなく、「コードで実装すべき部分」と「LLM に任せる部分」を適切に切り分けることが重要です。本セッションでは、ログラス社が実践するAI Agent の設計思想と、継続的な改善を実現するための取り組みをご紹介いただきました。
講演では、数値計算やルールに基づく処理は決定論的なコードで担保し、文章生成や自然言語による説明はLLM に任せるという役割分担について解説されました。また、トレースを活用した原因分析や、決定論的なルールによる出力検証、ユーザーからのフィードバックを回帰テストとして蓄積する仕組みなど、本番運用を見据えた改善サイクルも紹介されました。
AI Agent の品質を維持するためには、モデルやプロンプトを調整するだけではなく、継続的に評価・検証できる仕組みを構築することが欠かせません。LLM の特性を理解しながら、システム全体として品質を担保する設計の重要性を学べるセッションとなりました。
〈当日Discord で寄せられた質問〉
Q. 利用者からの個別指摘を回帰テスト化する際、品質問題と個人の好みをどう区別すればよいのでしょうか。
A. 機械的に判別するのは難しいため、FDE(現場エンジニア)などがユーザーと直接対話し、それが本当に必要なシステム上の修正なのかを一つずつ紐解いています。顧客のこだわりなのか、仕様上の品質問題なのかを、最終的にはビジネス上の判断として見極めていくことが重要だと考えています。
Q. モデルのアップデートやプロンプトの調整は、どのように運用するのがよいのでしょうか。
A. モデルのバージョンは基本的に固定して運用しています。プロンプトの調整については、制約を足していくのではなく、減らしていく「引き算」の発想が有効だと考えています。システムプロンプトで細かく制約していた部分を少しずつ緩め、LLM の自由な解釈に任せられる部分を増やしていく形で最適化しています。
4. 懇親会
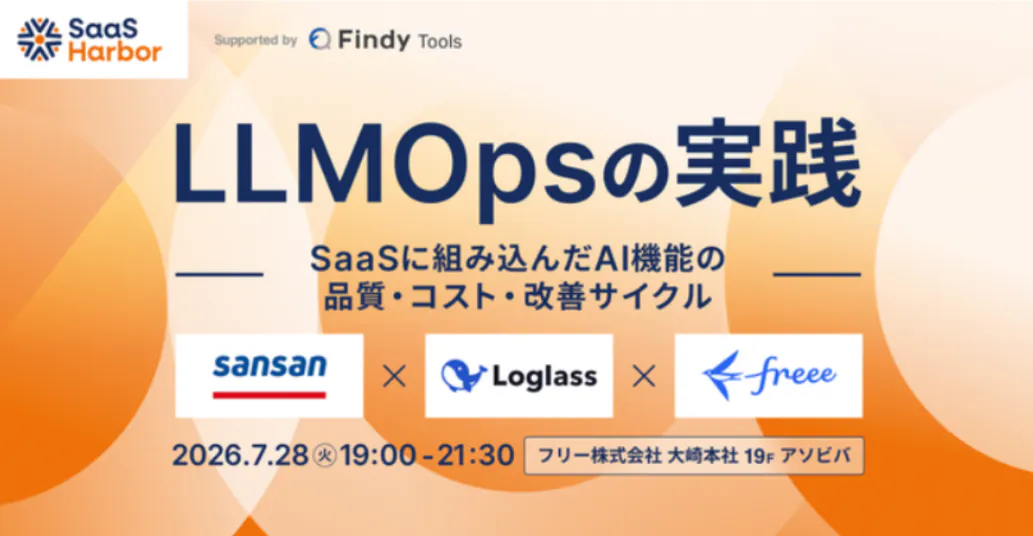
セッションを終えた会場では、さっそく参加者同士の会話が弾み 、熱気と余韻を引き継ぐように懇親会が始まりました 。
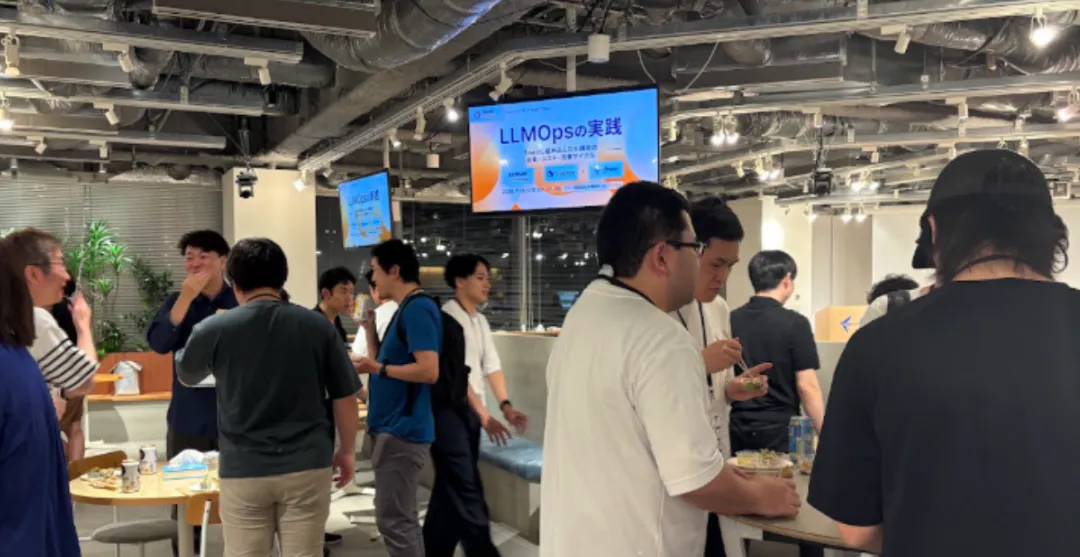
今回取り上げたLLM Opsは、多くの参加者がまさに日々の業務で向き合っているテーマでもあります。Langfuseの運用ノウハウやAI活用に伴うコスト、AIが生成したコードのレビューなど、セッションで取り上げられた話題をきっかけに、「自社ではどうしているか」「実際に運用してみて、どこに難しさを感じているか」といった、それぞれの現場での悩みや実践について会話が交わされていました。
登壇者に直接質問を投げかけ、セッション内容をさらに掘り下げる方の姿も印象的でした。登壇者の実体験や、実践の背景にある工夫まで直接聞き、自分たちの現場と照らし合わせながら学びを深められるのは、オフラインで集まるからこその大きな魅力です。
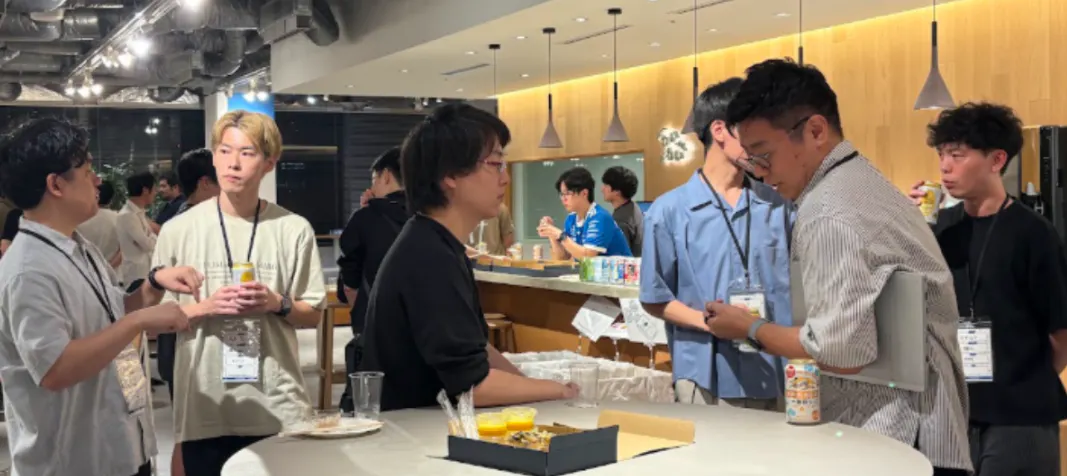
参加者はエンジニアに限らず、LLM Ops に関心を持つさまざまな職種の方が集まっており、多様な会話が広がっていました。一つのテーブルにとどまらず、別のテーブルへ移りながら交流する方も多く、初対面同士で会話を楽しむ姿も多く見られました。
こうした交流を通じて、それぞれが持つ現場の知見が持ち寄られ、互いに交換されていくことが、SaaS Harbor の懇親会ならではの魅力です。セッションで得た学びが会話の中でさらに深まり、普段は出会わない人とのつながりも生まれていました。会場では、そのような温かく刺激的な時間が最後まで続いていました。
5. 今後のイベントのお知らせ
SaaS Harbor は、ここからさらに加速していきます。次回の寄港予定は以下の通りです!
【SaaS Harbor #4】オンライン・セッション @Zoom
・日程: 9月下旬
・テーマ: SaaS インフラアーキテクチャ選択のリアル ── マルチテナントSaaS の設計思想(仮)
また、継続的な交流の場としてDiscord もご案内しています。こちらもぜひご参加ください。
Discord:https://discord.gg/Jgqdd38gE2
皆さまの「航海」がより実りあるものになるよう、これからも最高の知見が集まる港を作っていきます。
次回のイベントでお待ちしております!
⚓ SaaS Harbor 運営